AI 订阅的「五倍价值」:SemiAnalysis 免费部分译读
同样支付一笔订阅费,到底能使用多少模型额度?SemiAnalysis 的一篇文章把这个问题拆成了可测量的 token 消耗。标题中的「五倍价值」,对应的是特定模型与工作负载下的 API 等值额度。
来源与阅读范围
原文:Anthropic Subscriptions Offer 5x+ More Value Than OpenAI
译名:「Anthropic 订阅提供的价值超过 OpenAI 五倍」
作者:Andrew Megalaa、Max Kan、Dylan Patel
发布日期:2026-10-05
本文对免费可见部分做要点译述与图表解读,范围包括测量方法、两家原厂订阅、限额调整、补贴模型和国产方案。图表数值转录自原文,倍数为根据显示值计算的近似值。所有金额均为美元,代表原文发布时的数据快照。
先读懂两个指标
API 等值额度:订阅能够承载的 token 用量,按照对应模型的 API 标价折算成金额。
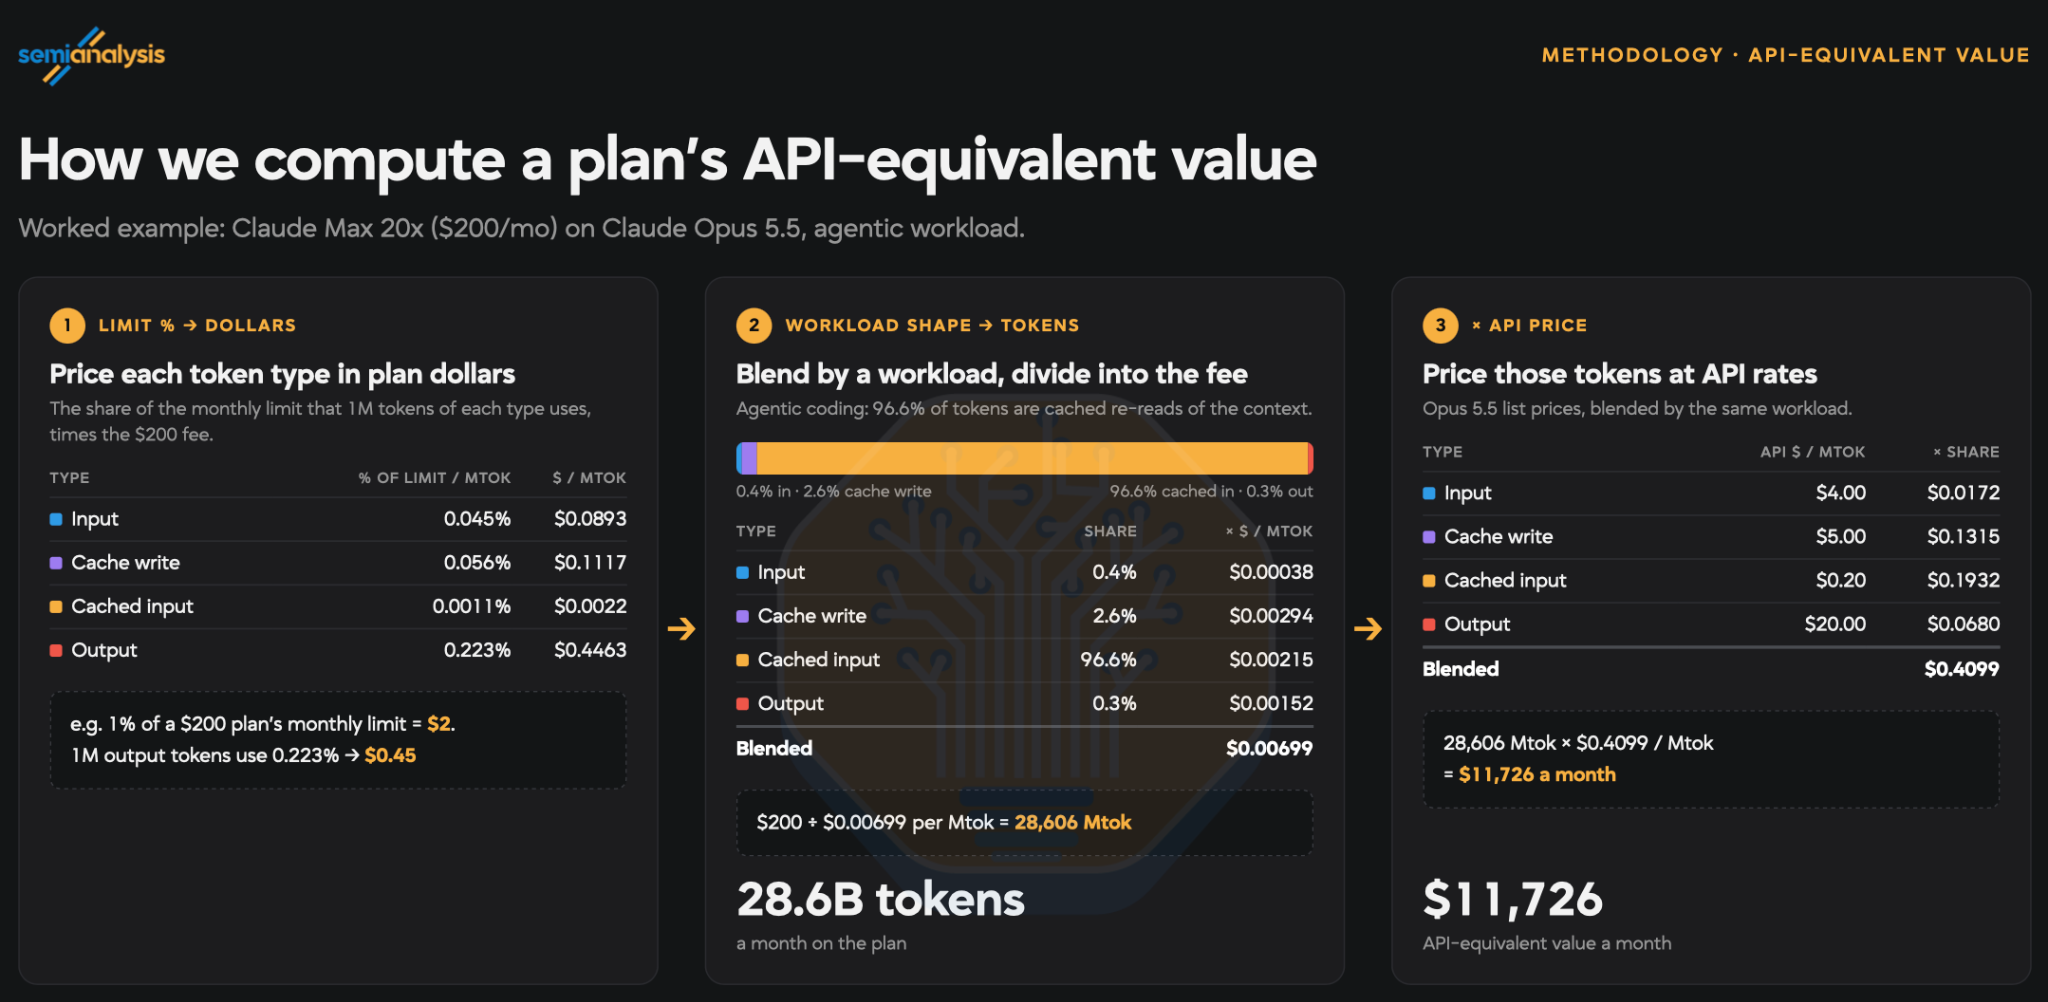
API 等值额度 = Σ(各类 token 数量 ÷ 1,000,000 × 对应 API 单价)
总 token 数量:累计处理的输入、缓存写入、缓存读取和输出 token。这里包含多轮请求中反复读取的历史上下文;实际生成的新内容对应输出部分。
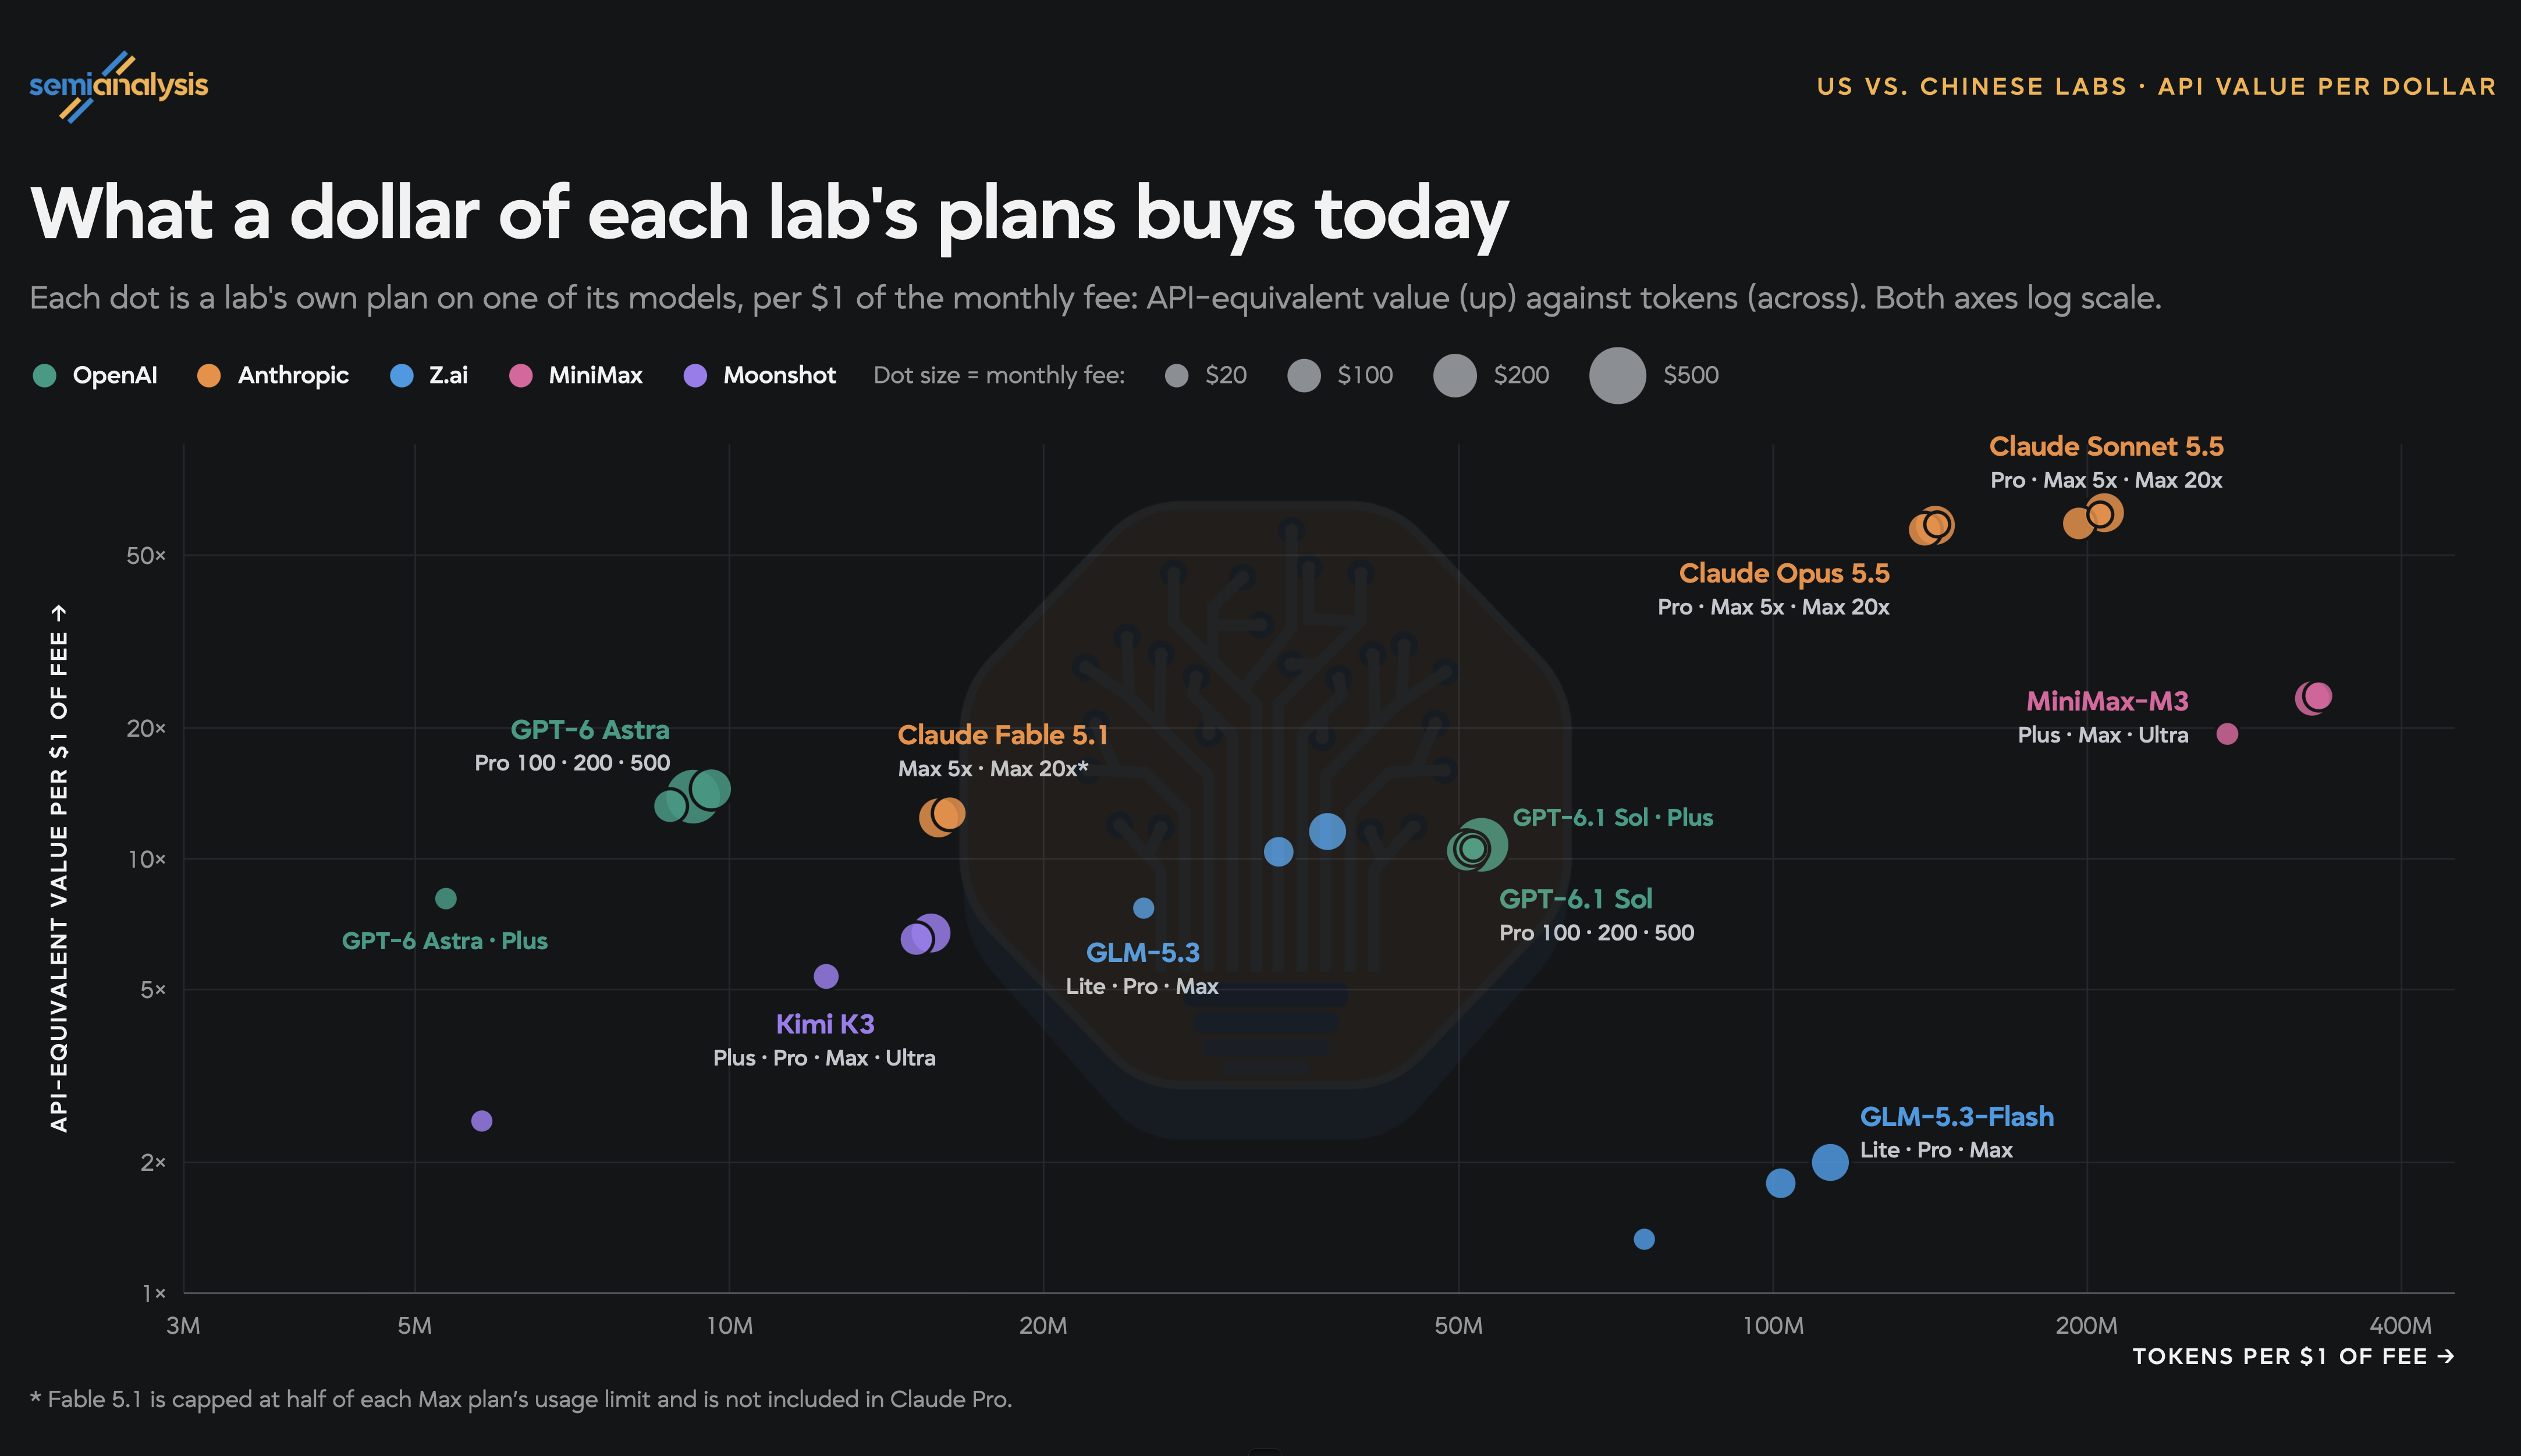
把 API 等值额度除以月费,还能得到每一美元订阅费对应多少美元的 API 用量。例如,$200 月费对应 $11,726 的 API 等值额度,就是约 58.6 倍。跨厂商比较时,需要再比较两家的折算值。
额度是怎么测出来的
作者尽量让一次实验以一类 token 为主,记录请求用量和用量计变化,再反推每百万 token 消耗多少额度。更换输入标签、重复使用上下文等操作用于区分新输入与缓存消耗。
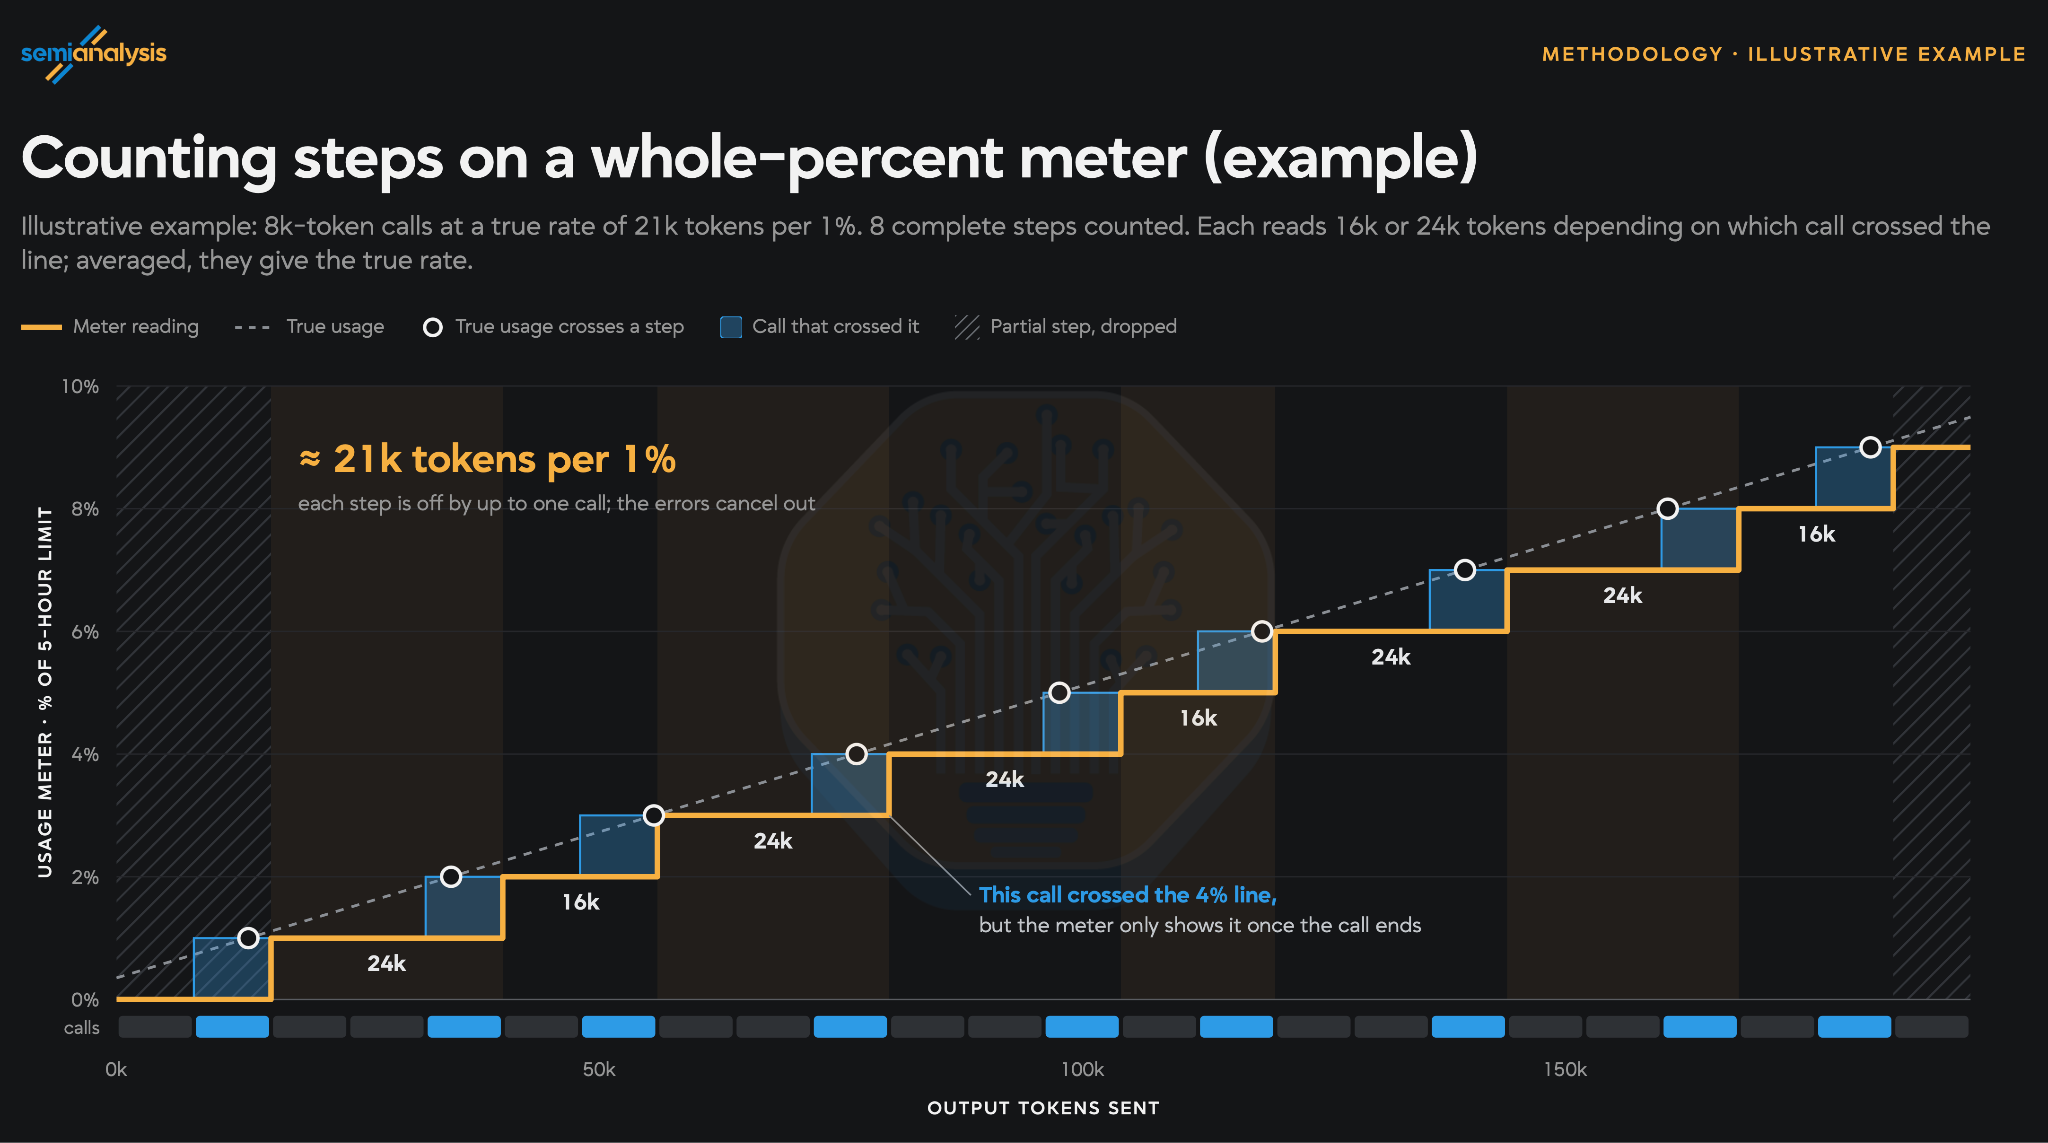
用量计按整数百分比跳动时,一次请求可能跨过刻度。测量因此统计连续的完整区间,舍弃首尾不完整区间,并把估计范围收窄到约 ±5%。原文还报告了一次同类账号限额相差约 20% 的 A/B 测试经历。测量过程示意图、原文说明。
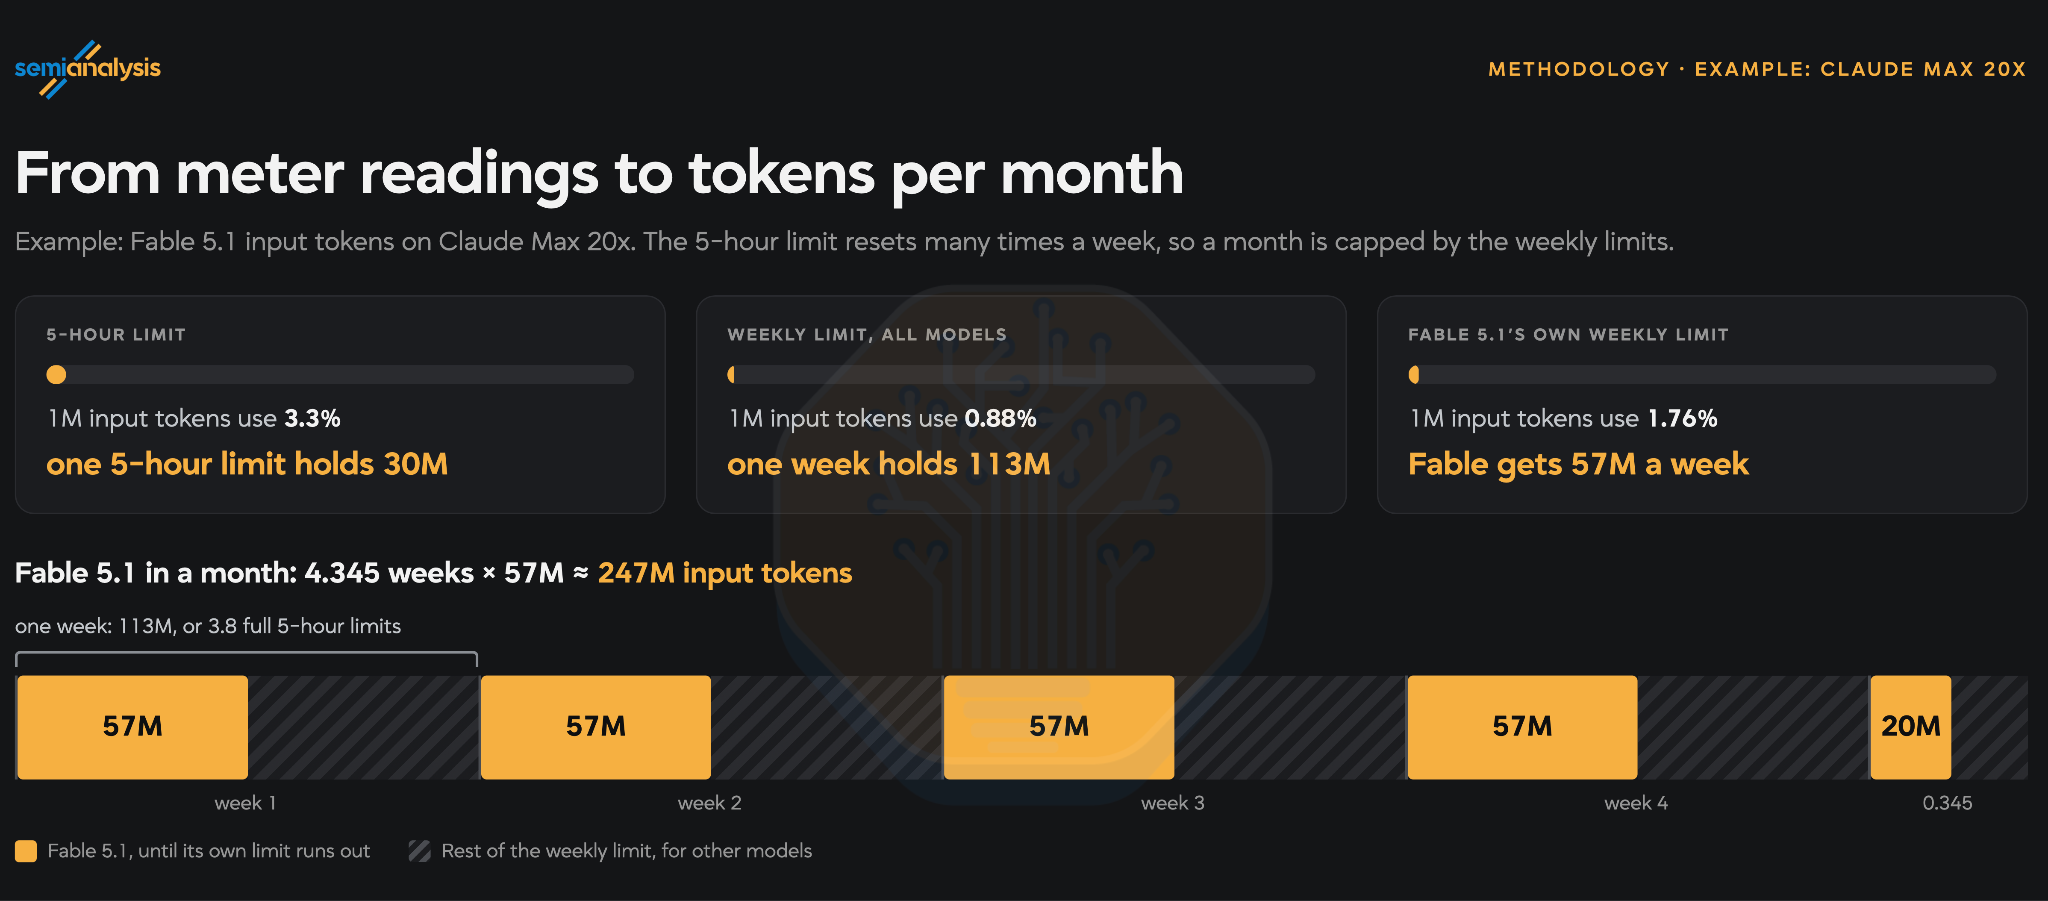
短时限额、全模型周限额、特定模型周限额会同时约束使用。例如,原图中 Fable 的专属周额度先耗尽,其他模型仍有剩余额度。将周额度折算为月度用量,也隐含了能够持续使用这些额度的假设。时间窗口示意图。
主力模型:「五倍」对应什么
API 等值额度
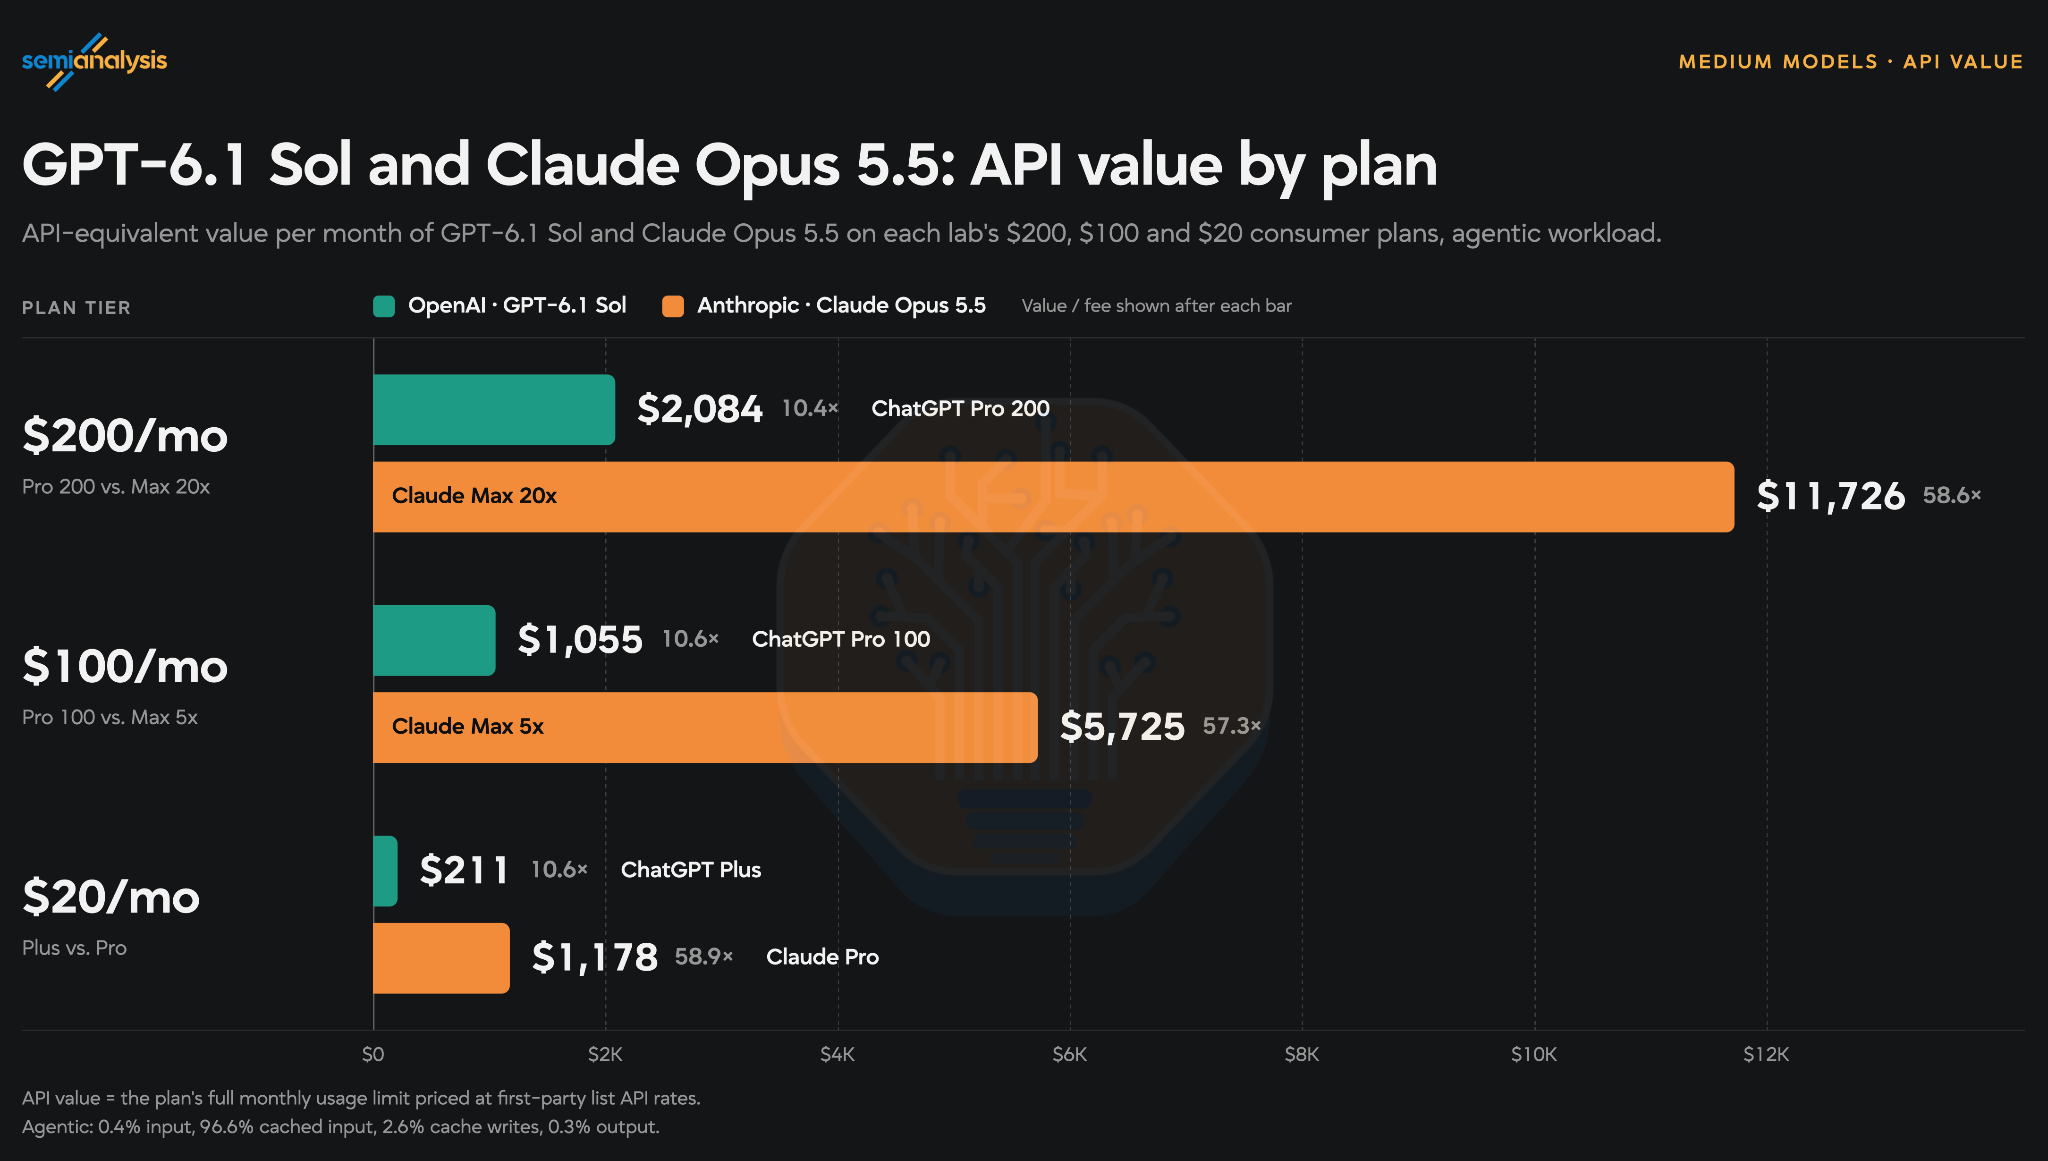
原图比较 GPT-6.1 Sol 与 Claude Opus 5.5,采用作者的 Agent 工作负载:
| 月费 | OpenAI / Sol | Claude / Opus | Claude ÷ OpenAI |
|---|---|---|---|
| $20 | $211 | $1,178 | 约 5.58 倍 |
| $100 | $1,055 | $5,725 | 约 5.43 倍 |
| $200 | $2,084 | $11,726 | 约 5.63 倍 |
OpenAI 的三档分别为 Plus、Pro 100、Pro 200;Claude 对应 Pro、Max 5x、Max 20x。以上均为按月折算的 API 等值额度。API 等值额度原图。
总 token 数量
| 月费 | OpenAI / Sol | Claude / Opus | Claude ÷ OpenAI |
|---|---|---|---|
| $20 | 10 亿 | 29 亿 | 约 2.90 倍 |
| $100 | 51 亿 | 140 亿 | 约 2.75 倍 |
| $200 | 102 亿 | 286 亿 | 约 2.80 倍 |
原图使用 B,即十亿 token;上表换算为「亿」。显示值已经经过取整,倍数也只保留近似精度。总 token 原图。
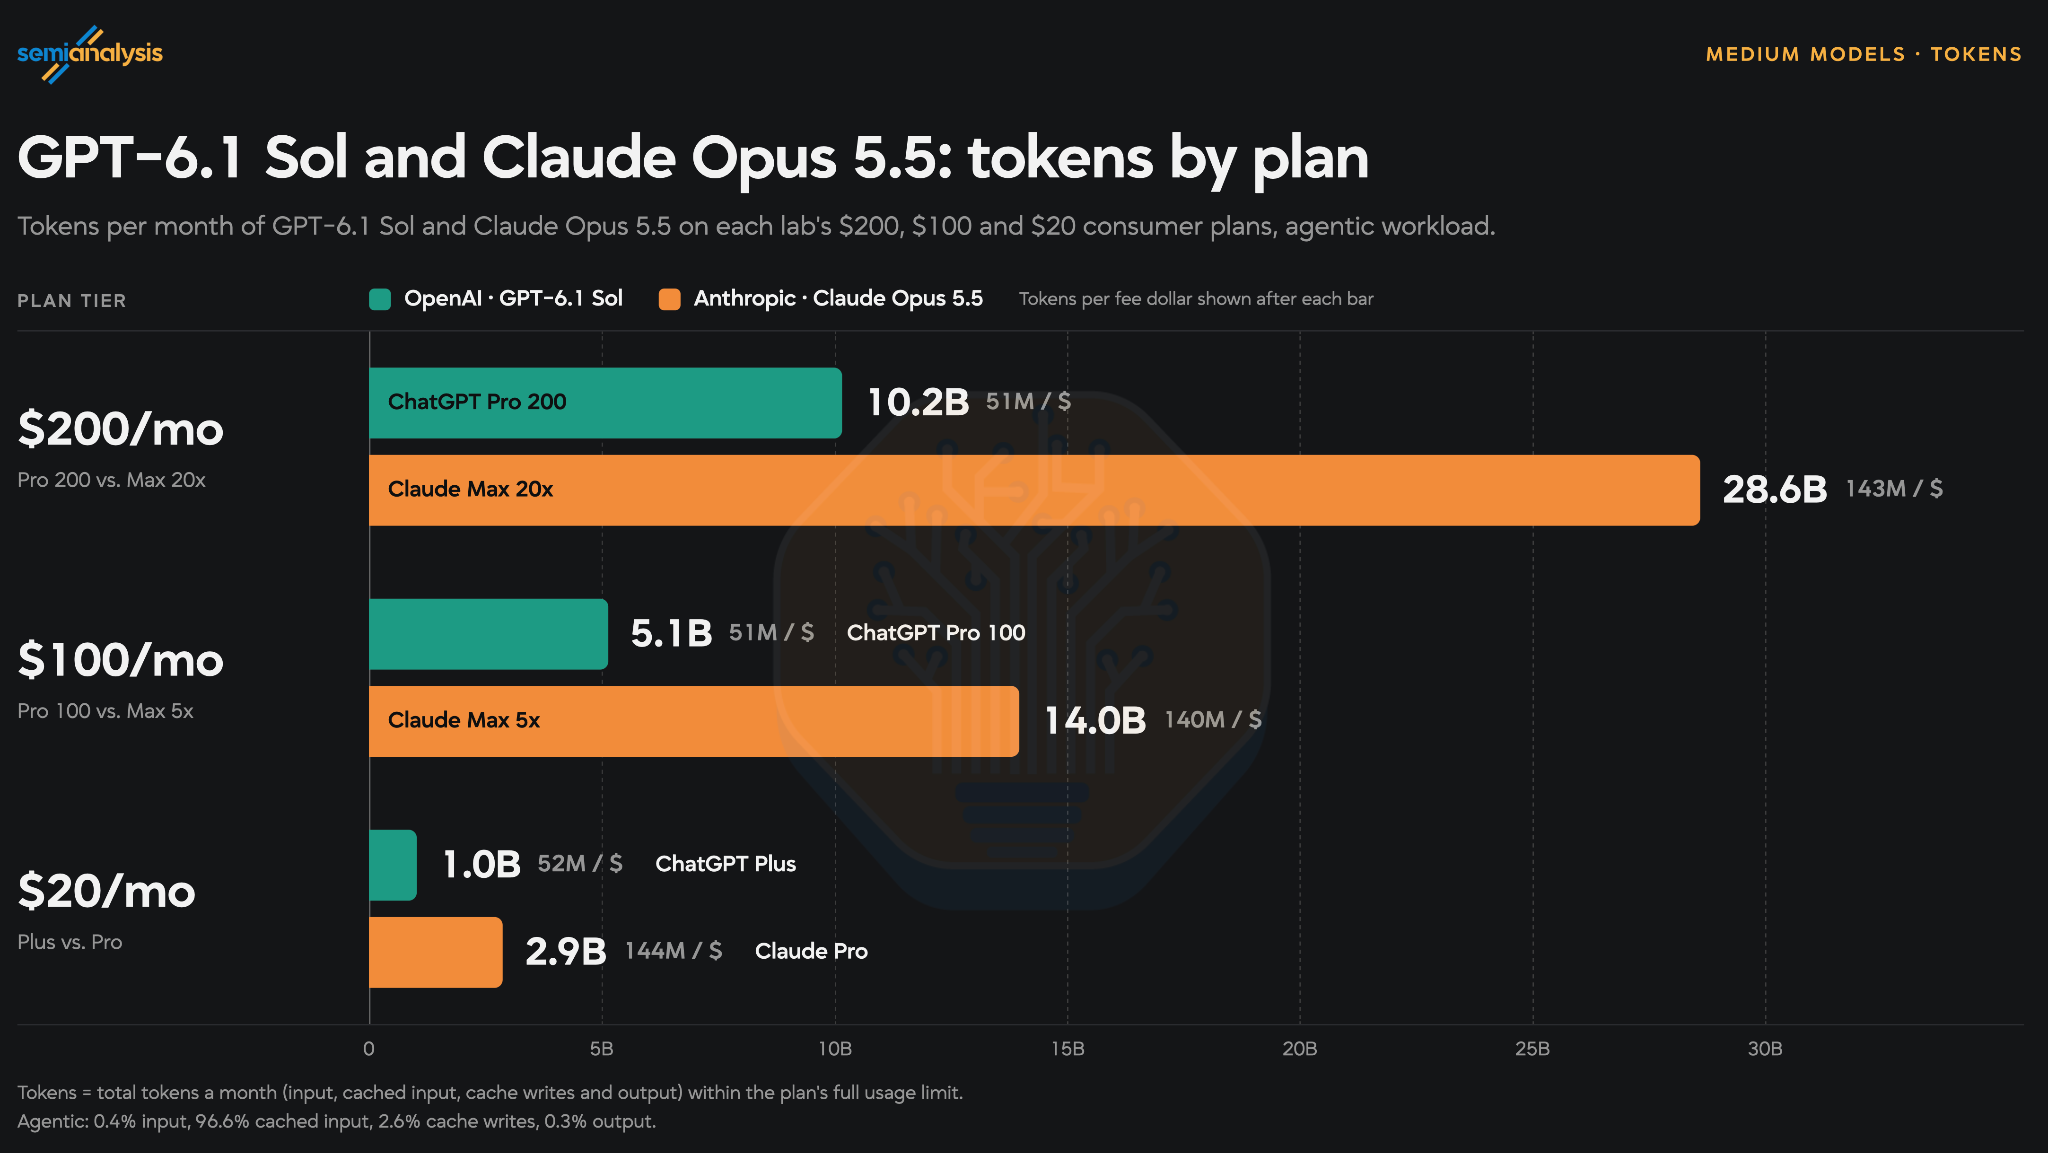
本文解读:两项指标都显示了 Claude 在这组模型上的额度优势,但倍率不同。以 $200 档为例,API 等值额度相差约 5.63 倍,总 token 相差约 2.80 倍;余下的差异来自对应模型的 API 计价。
按显示值估算,Sol 的加权 API 单价约为 $2,084 ÷ 10,200 ≈ $0.204/百万 token,Opus 约为 $11,726 ÷ 28,600 ≈ $0.410/百万 token。两者约两倍的单价差,再乘约 2.8 倍的 token 差,得到约 5.6 倍的等值金额差。
工作负载决定了这些数字的含义
原图使用的 Agent token 比例如下,显示百分比经过四舍五入:
| token 类型 | 占比 |
|---|---|
| 新输入 | 0.4% |
| 缓存写入 | 2.6% |
| 缓存读取 | 96.6% |
| 输出 | 0.3% |
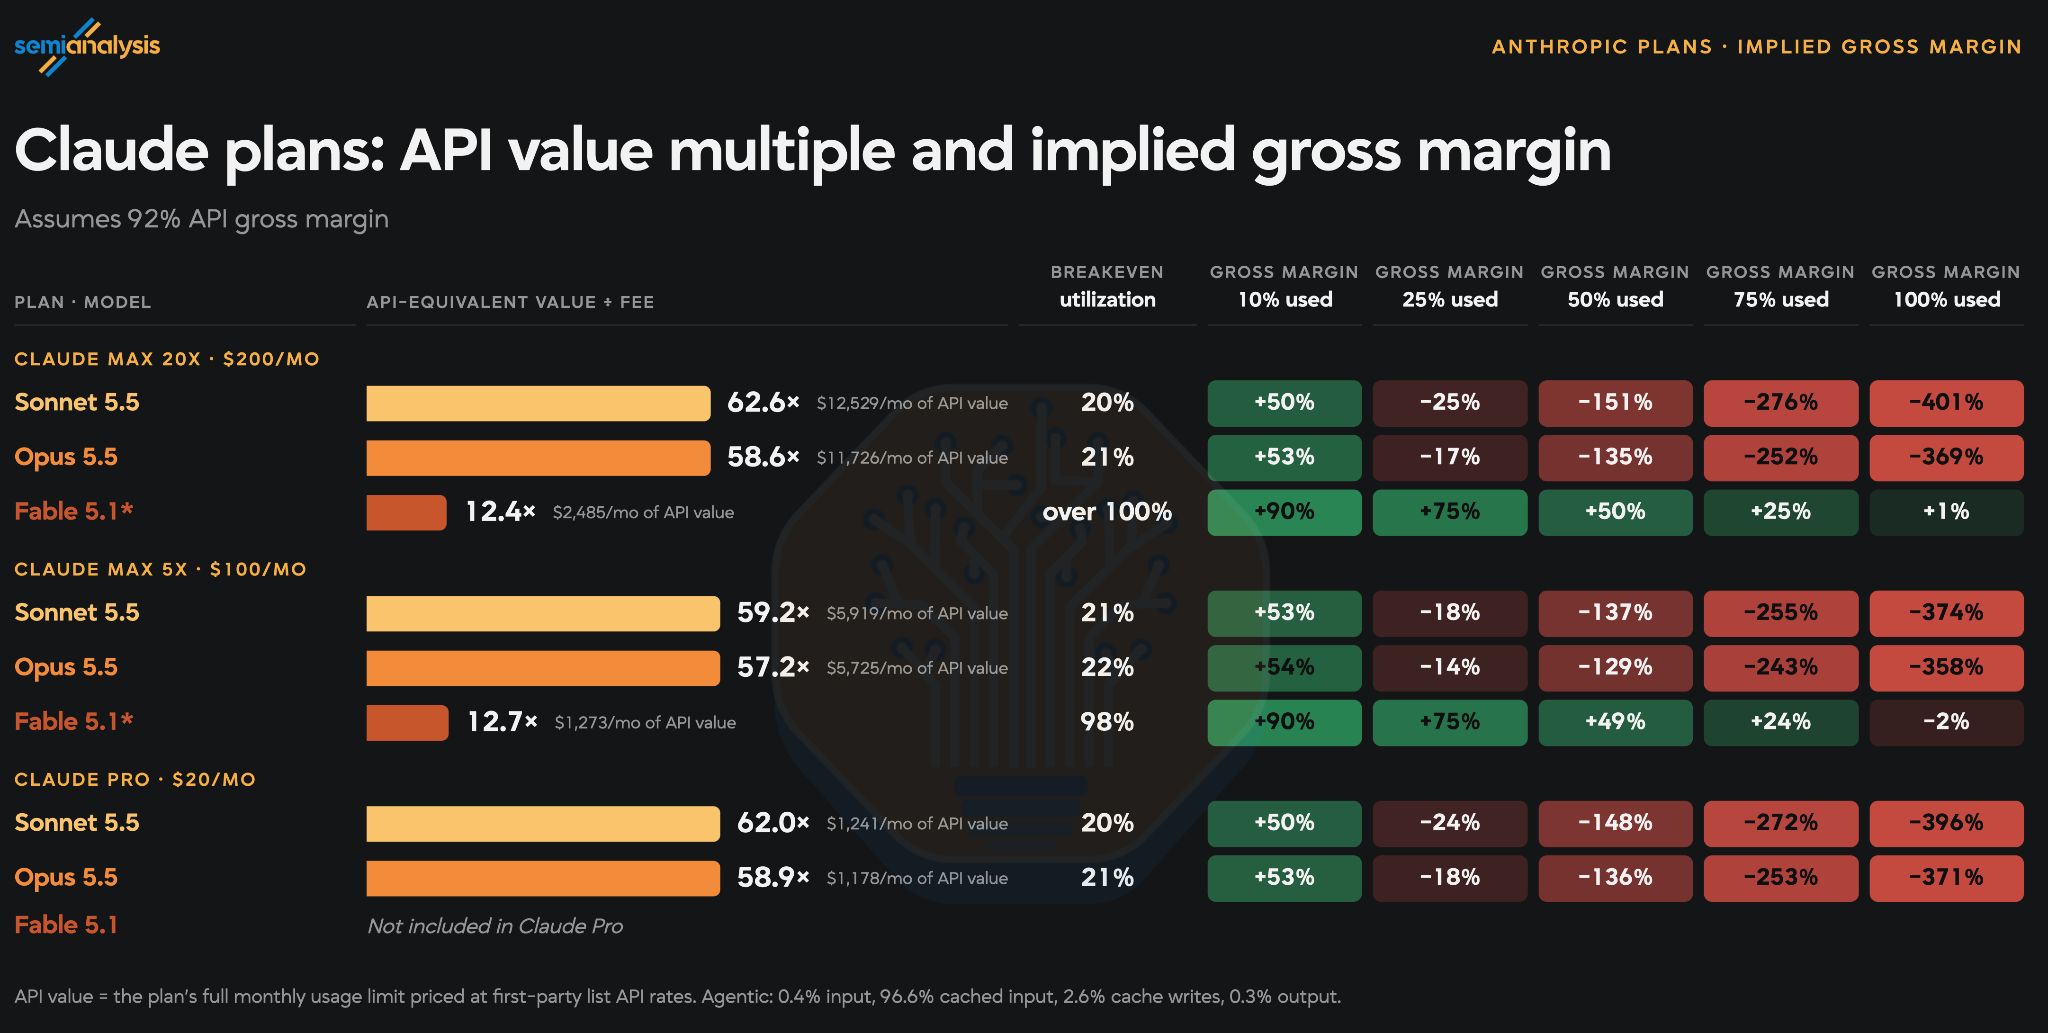
这是一种高度依赖上下文缓存的工作负载。原图给 Opus 5.5 计算出的加权 API 单价约为每百万 token $0.41,286 亿 token 按这个价格折算,约为 $11,726。完整计算图。
同一张 $200 Claude 订阅,在原文采用的 Chat 工作负载下,Opus 的 API 等值额度变为 $9,200;Chat 的缓存读取占比为 75%,输出占比为 10%。模型、订阅档位、使用结构共同决定折算结果。不同工作负载原图。
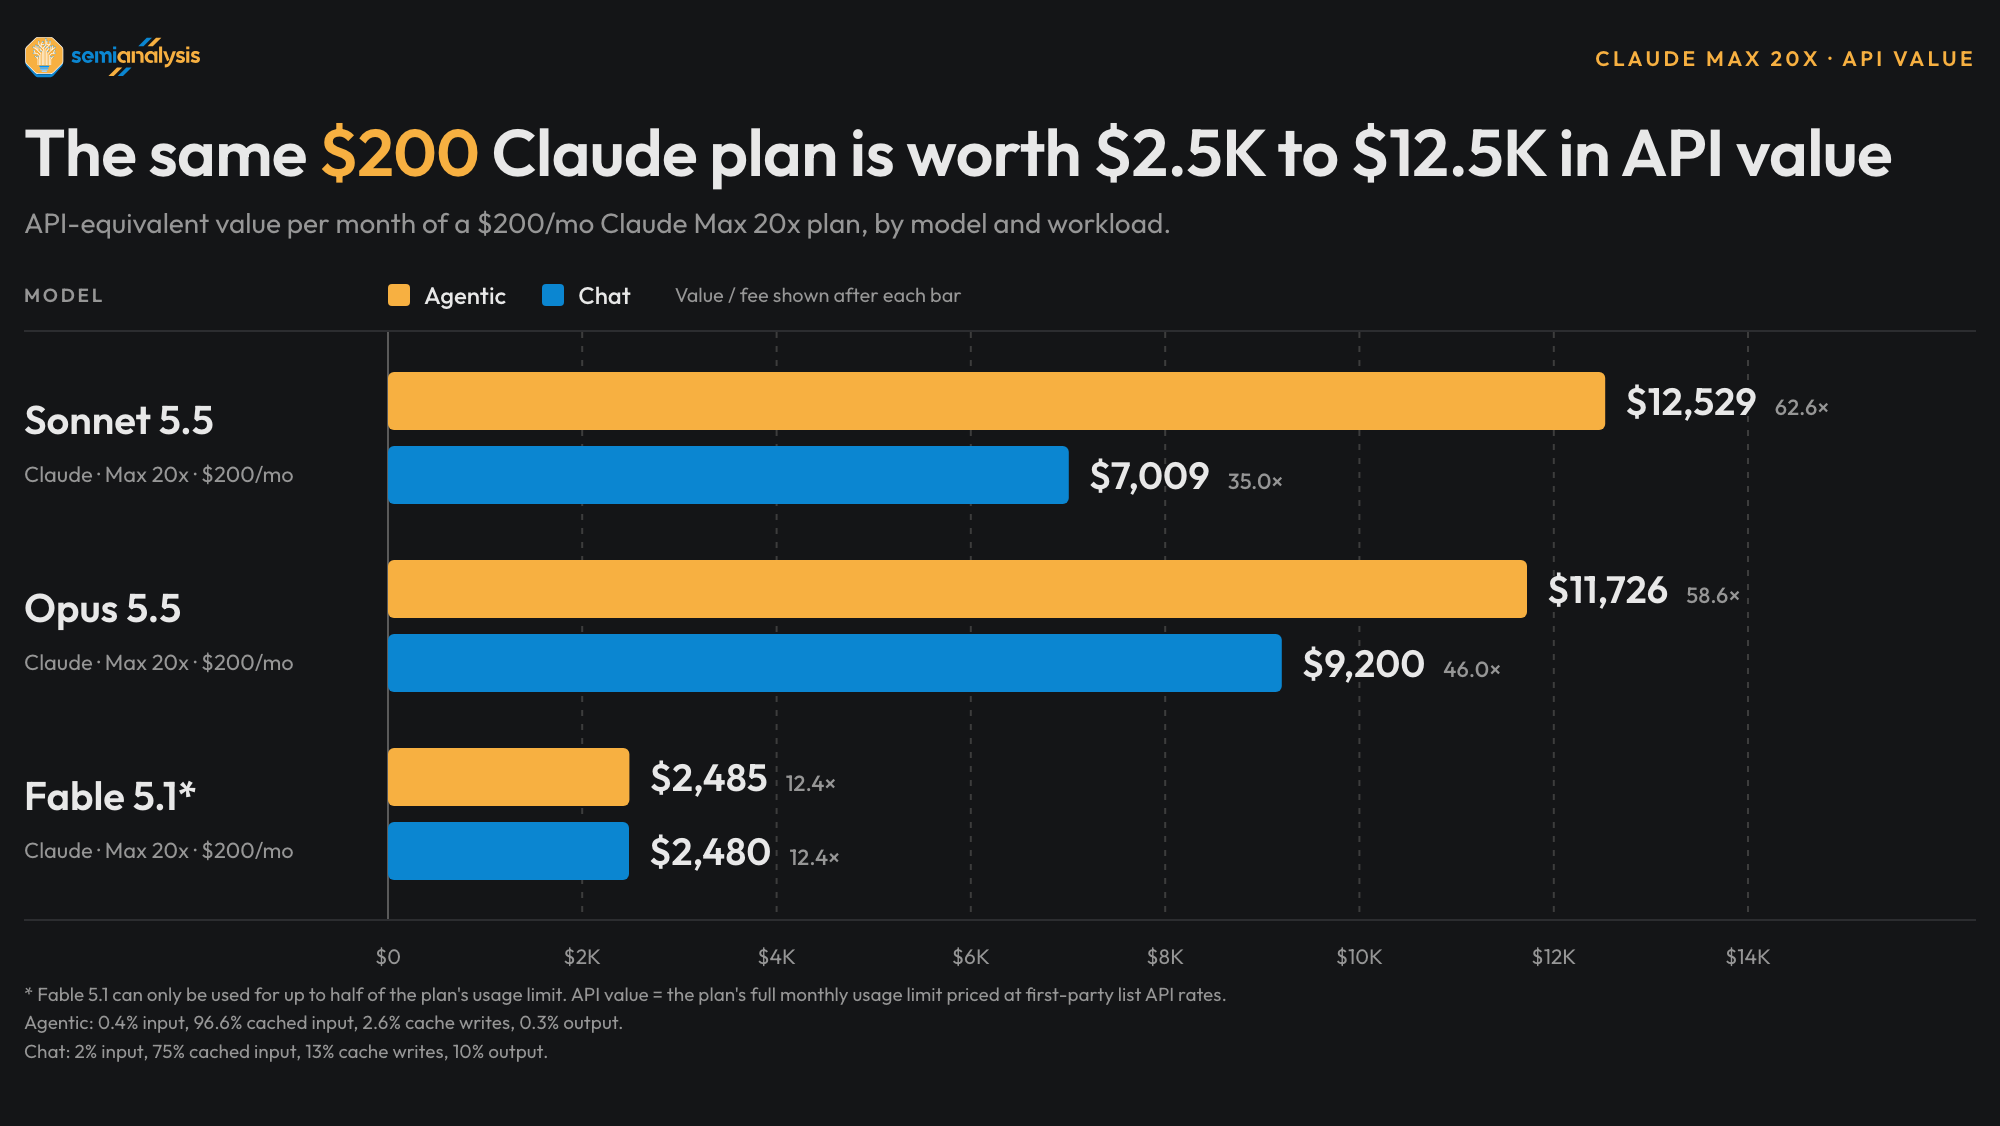
本文解读:反复携带项目上下文的 Agent,和长篇输出、短对话的 token 结构会不同。比较额度时,先确认自己的缓存与输出比例,更容易判断这些测量数据是否贴近实际使用。
高端模型还要看专属限额
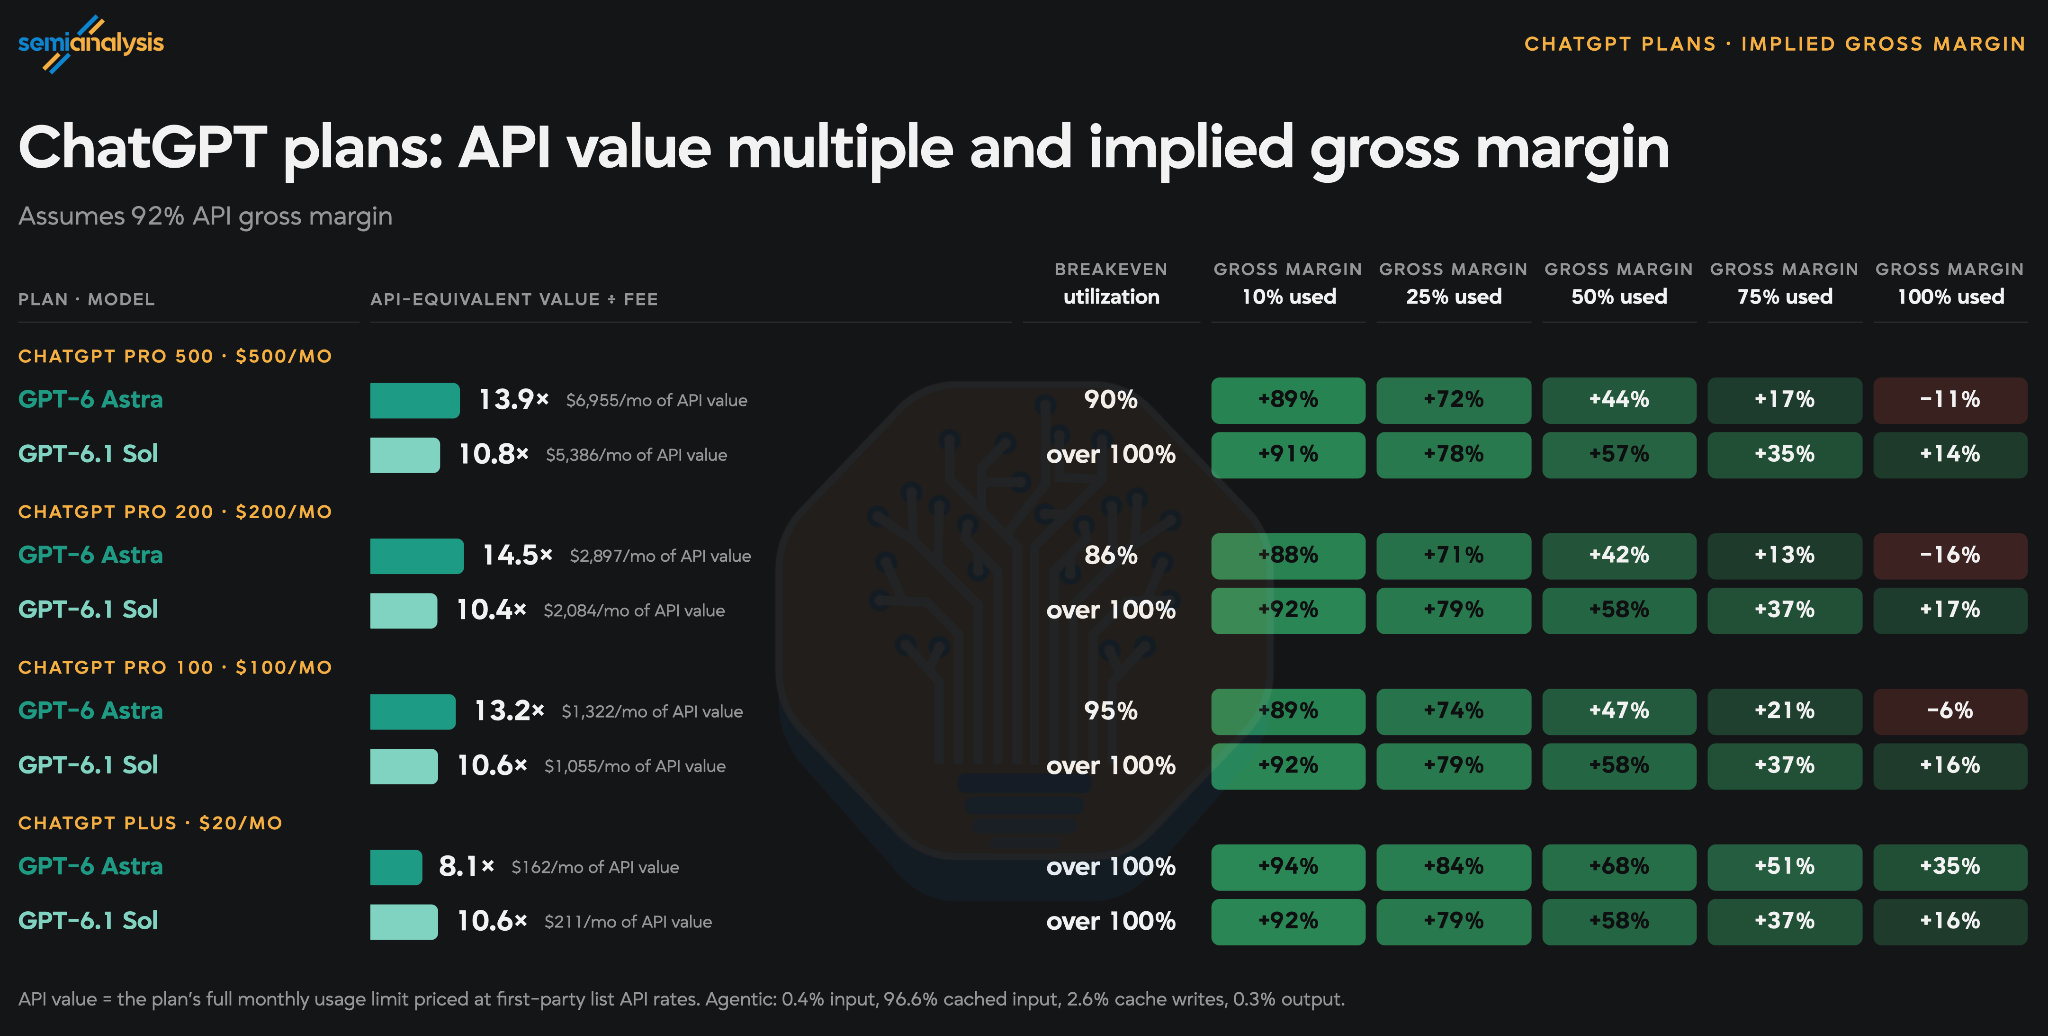
GPT-6 Astra 与 Claude Fable 5.1 的 API 等值额度如下:
| 月费 | OpenAI / Astra | Claude / Fable |
|---|---|---|
| $20 | $162 | 原图注明 Pro 不包含 Fable |
| $100 | $1,322 | $1,273 |
| $200 | $2,897 | $2,485 |
原图注明,Fable 最多使用对应 Max 套餐额度的一半。这一列耗尽后,Claude 仍有可供其他模型使用的额度;总订阅利用率需要连同这些余量一起考虑。高端模型原图。
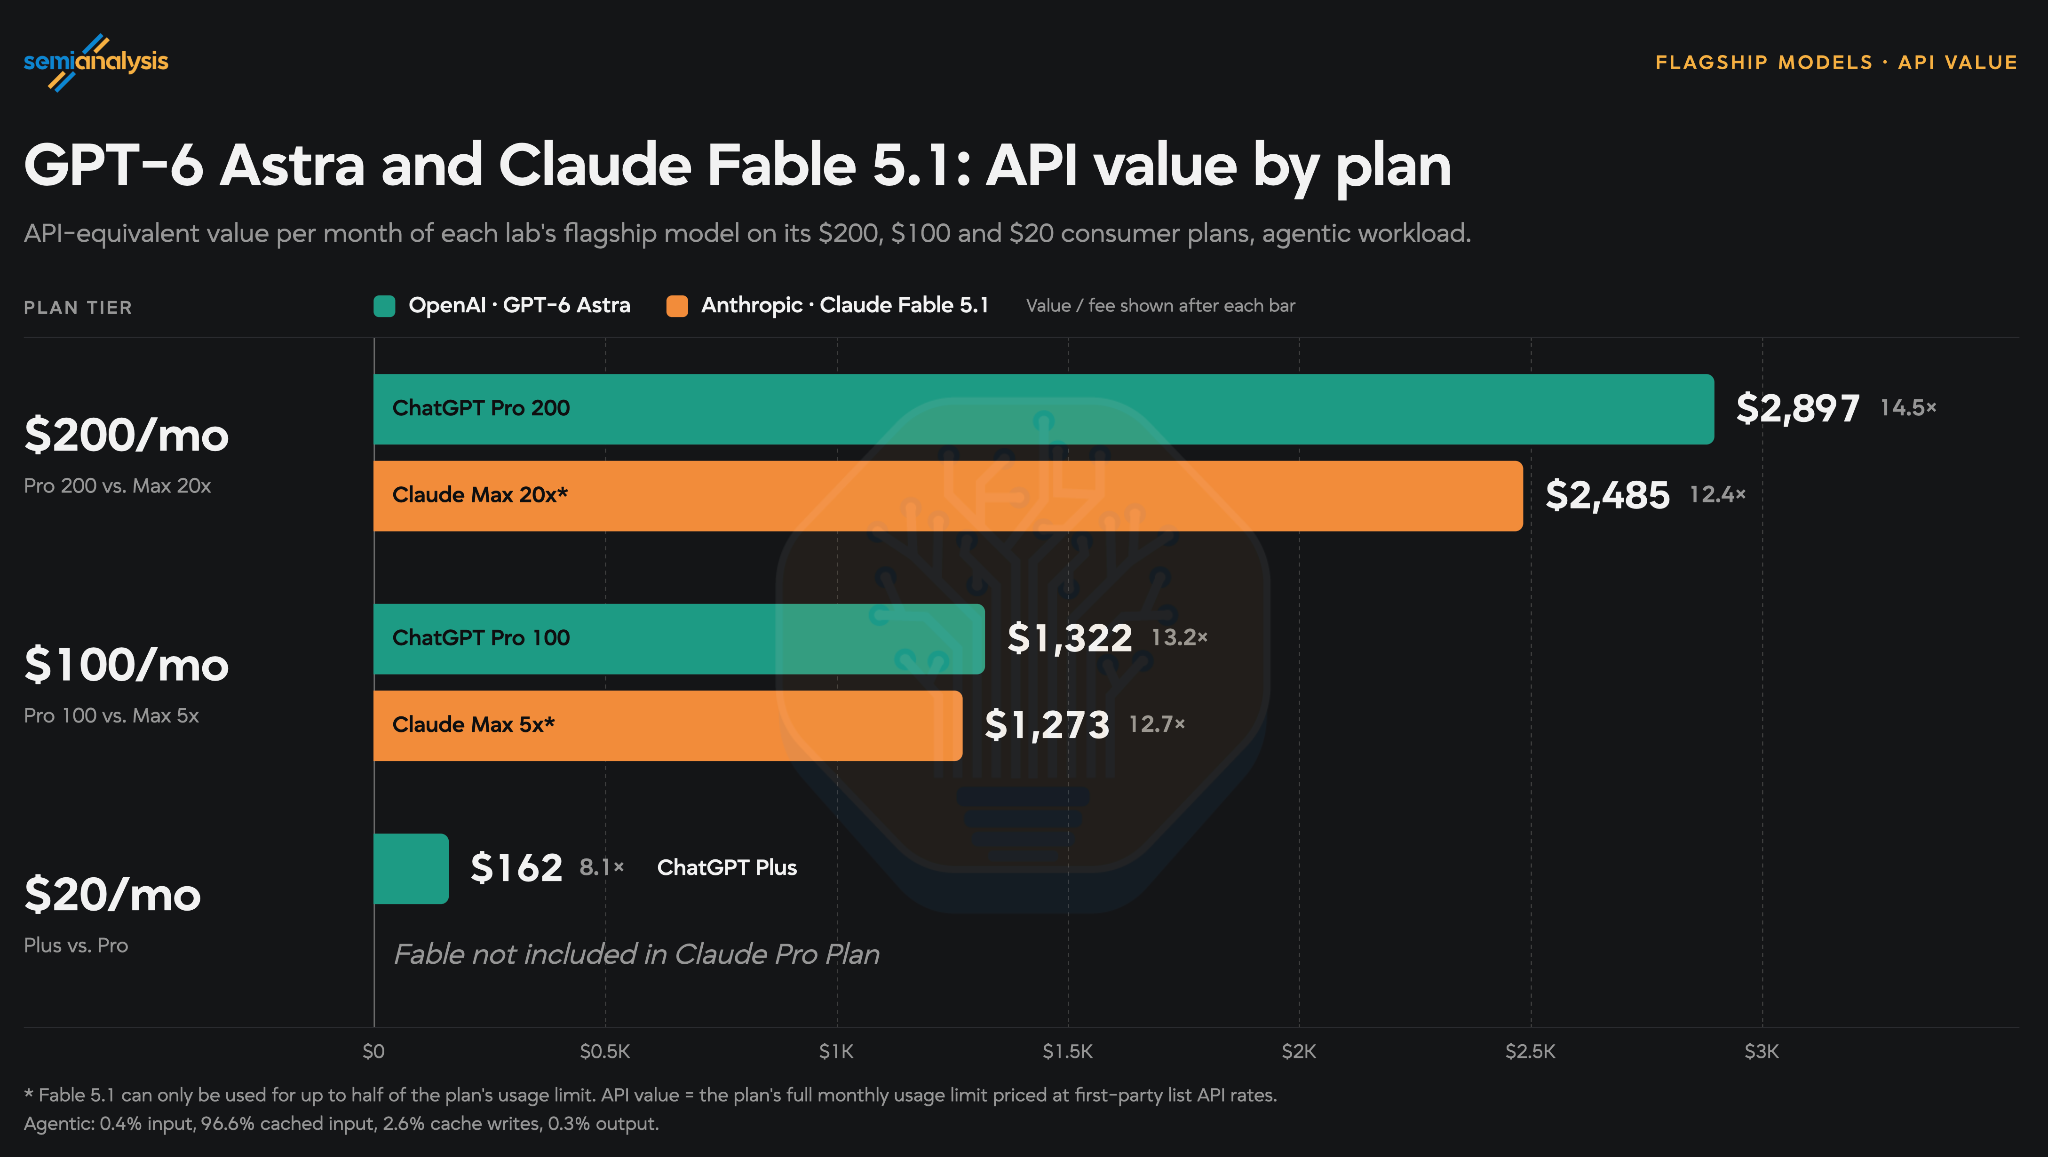
本文解读:主力模型与高端模型各有配额结构。评估一个套餐时,应把实际使用的模型组合及其共享额度、专属额度一并列出。
OpenAI 调整前后的差异
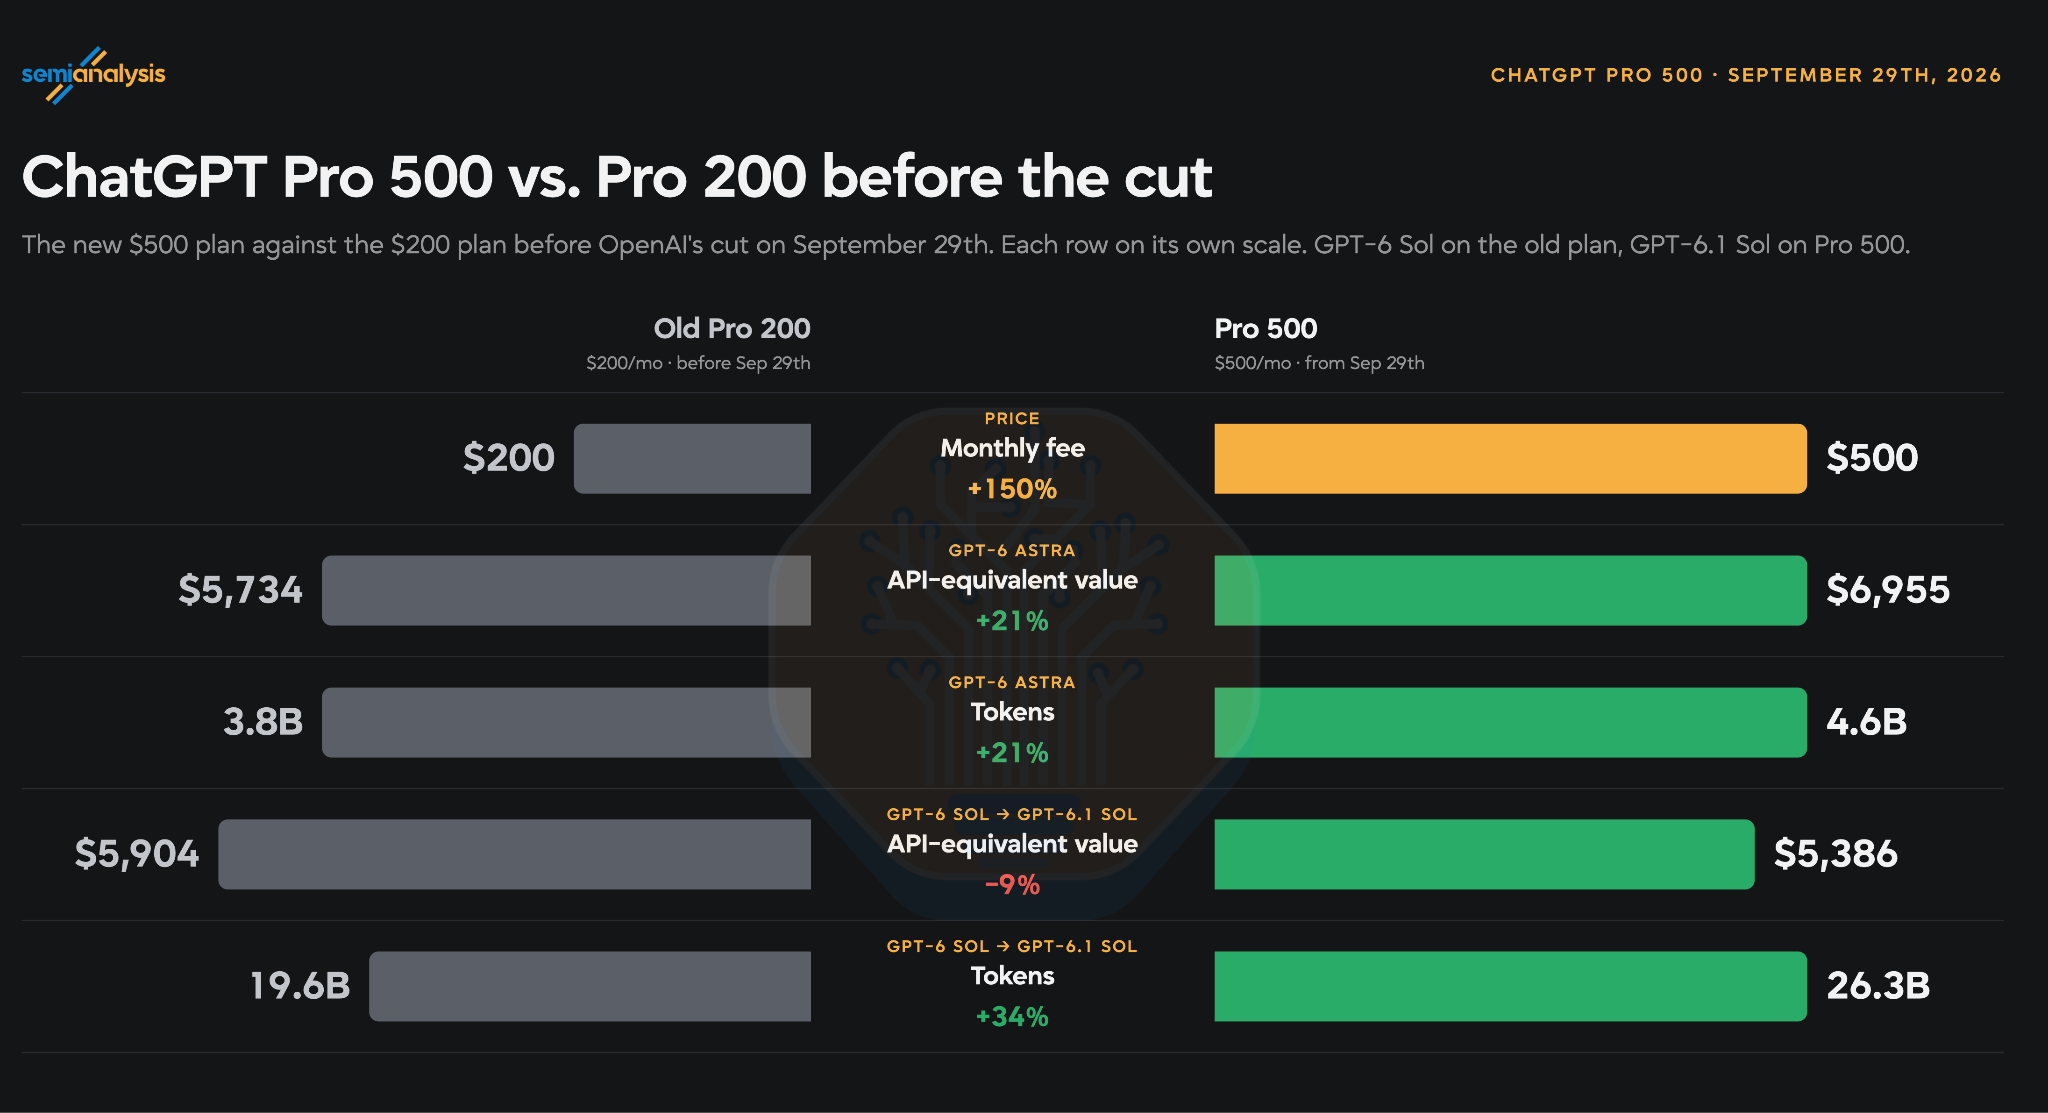
下面是原图记录的 2026-09-29 前后 Pro 200 数据。Sol 系列同时发生了 GPT-6 Sol 到 GPT-6.1 Sol 的模型替换。
| 指标 | 调整前 | 调整后 |
|---|---|---|
| Astra:API 等值额度 | $5,734 | $2,897 |
| Astra:总 token | 38 亿 | 19 亿 |
| Sol 系列:API 等值额度 | $5,904 | $2,084 |
| Sol 系列:总 token | 196 亿 | 102 亿 |
数据出处:Pro 200 调整前后原图。
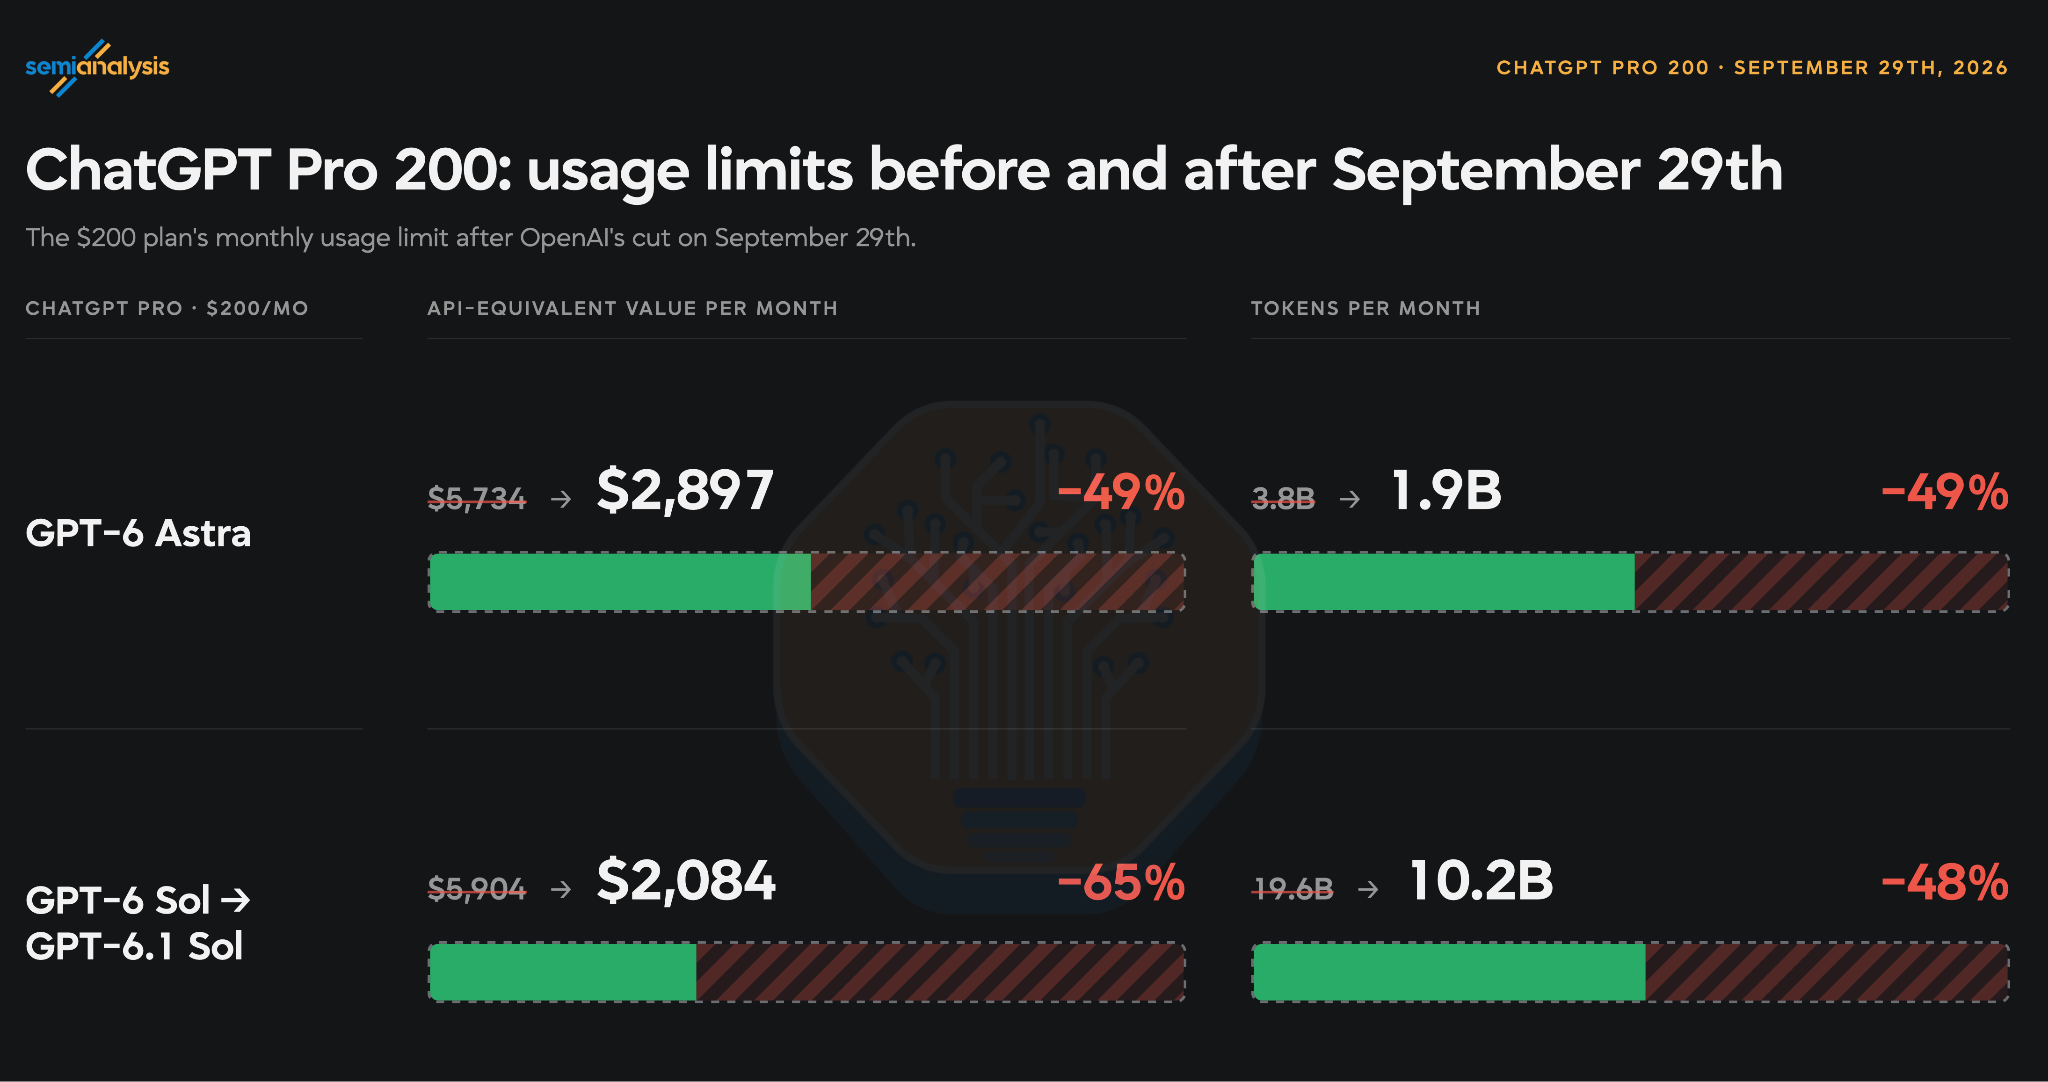
本文解读:额度和 API 单价的变化可以叠加。Sol 的 token 量约保留原来的 52%,按图中金额反推的加权 API 单价约保留 68%,两者相乘约为 35%,对应 API 等值金额下降约 65%。
原图还把新的 $500 套餐与调整前的 $200 套餐比较:月费增加 150%,Astra token 约增加 21%;Sol 系列 token 约增加 34%,API 等值金额却约减少 9%。这里的比较基准是调整前的旧套餐,Sol 还涉及前述模型替换。Pro 500 与旧 Pro 200 原图。
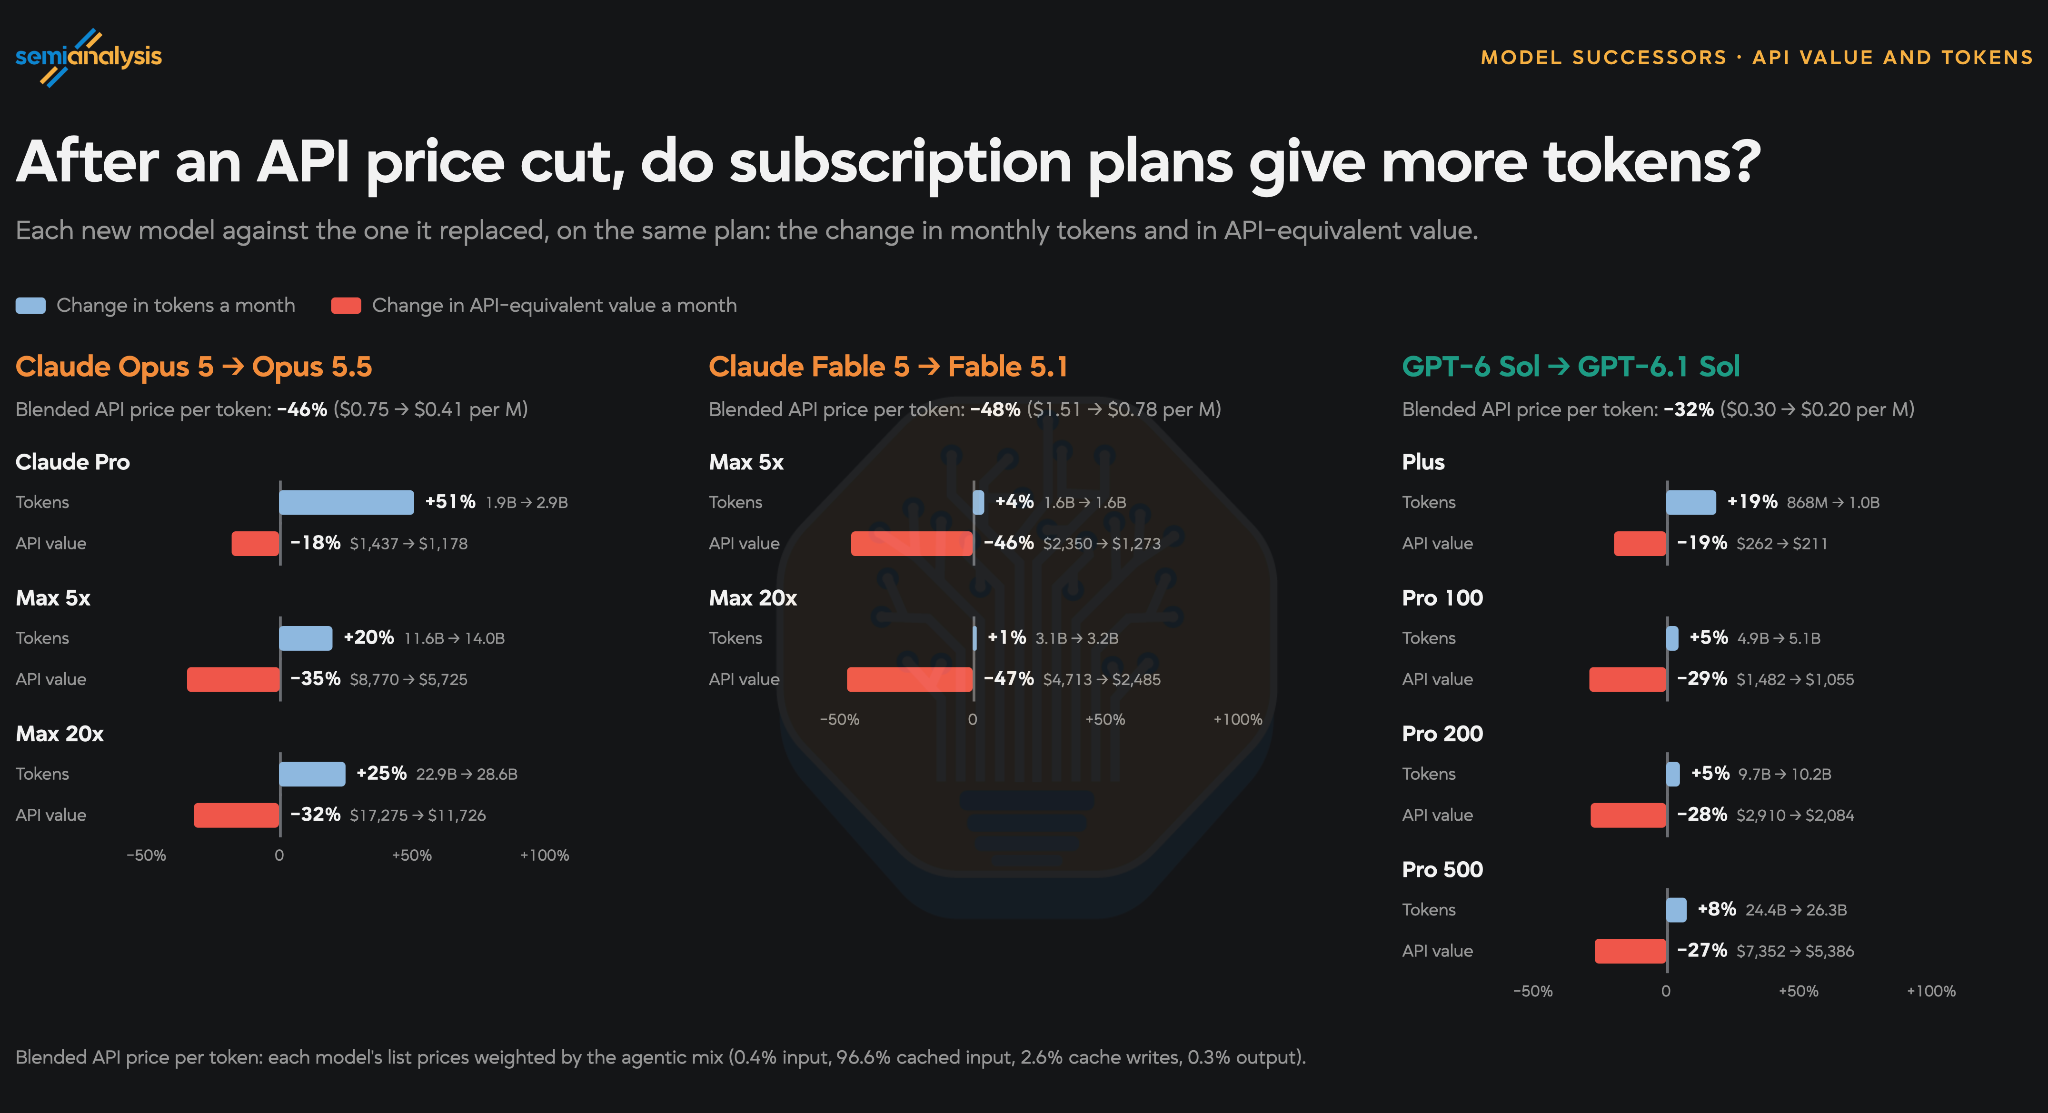
模型 API 降价、订阅 token 变化和套餐限额调整,需要分别记录,才能解释折算金额的变化。模型更替原图。
国产方案也有明显差异
从免费图表中选取三个高档位方案,使用相同的 Agent 口径:
| 方案 / 模型 | 月费 | API 等值额度 | 等值额度 ÷ 月费 |
|---|---|---|---|
| GLM Coding Max / GLM-5.3 | $168 | $1,942 | 约 11.6 倍 |
| MiniMax Token Ultra / MiniMax-M3 | $132 | $3,088 | 约 23.4 倍 |
| Kimi Code Ultra / Kimi K3 | $199 | $1,343 | 约 6.7 倍 |
表中金额为原图数据,最后一列由显示值计算并取一位小数。国产方案原图。
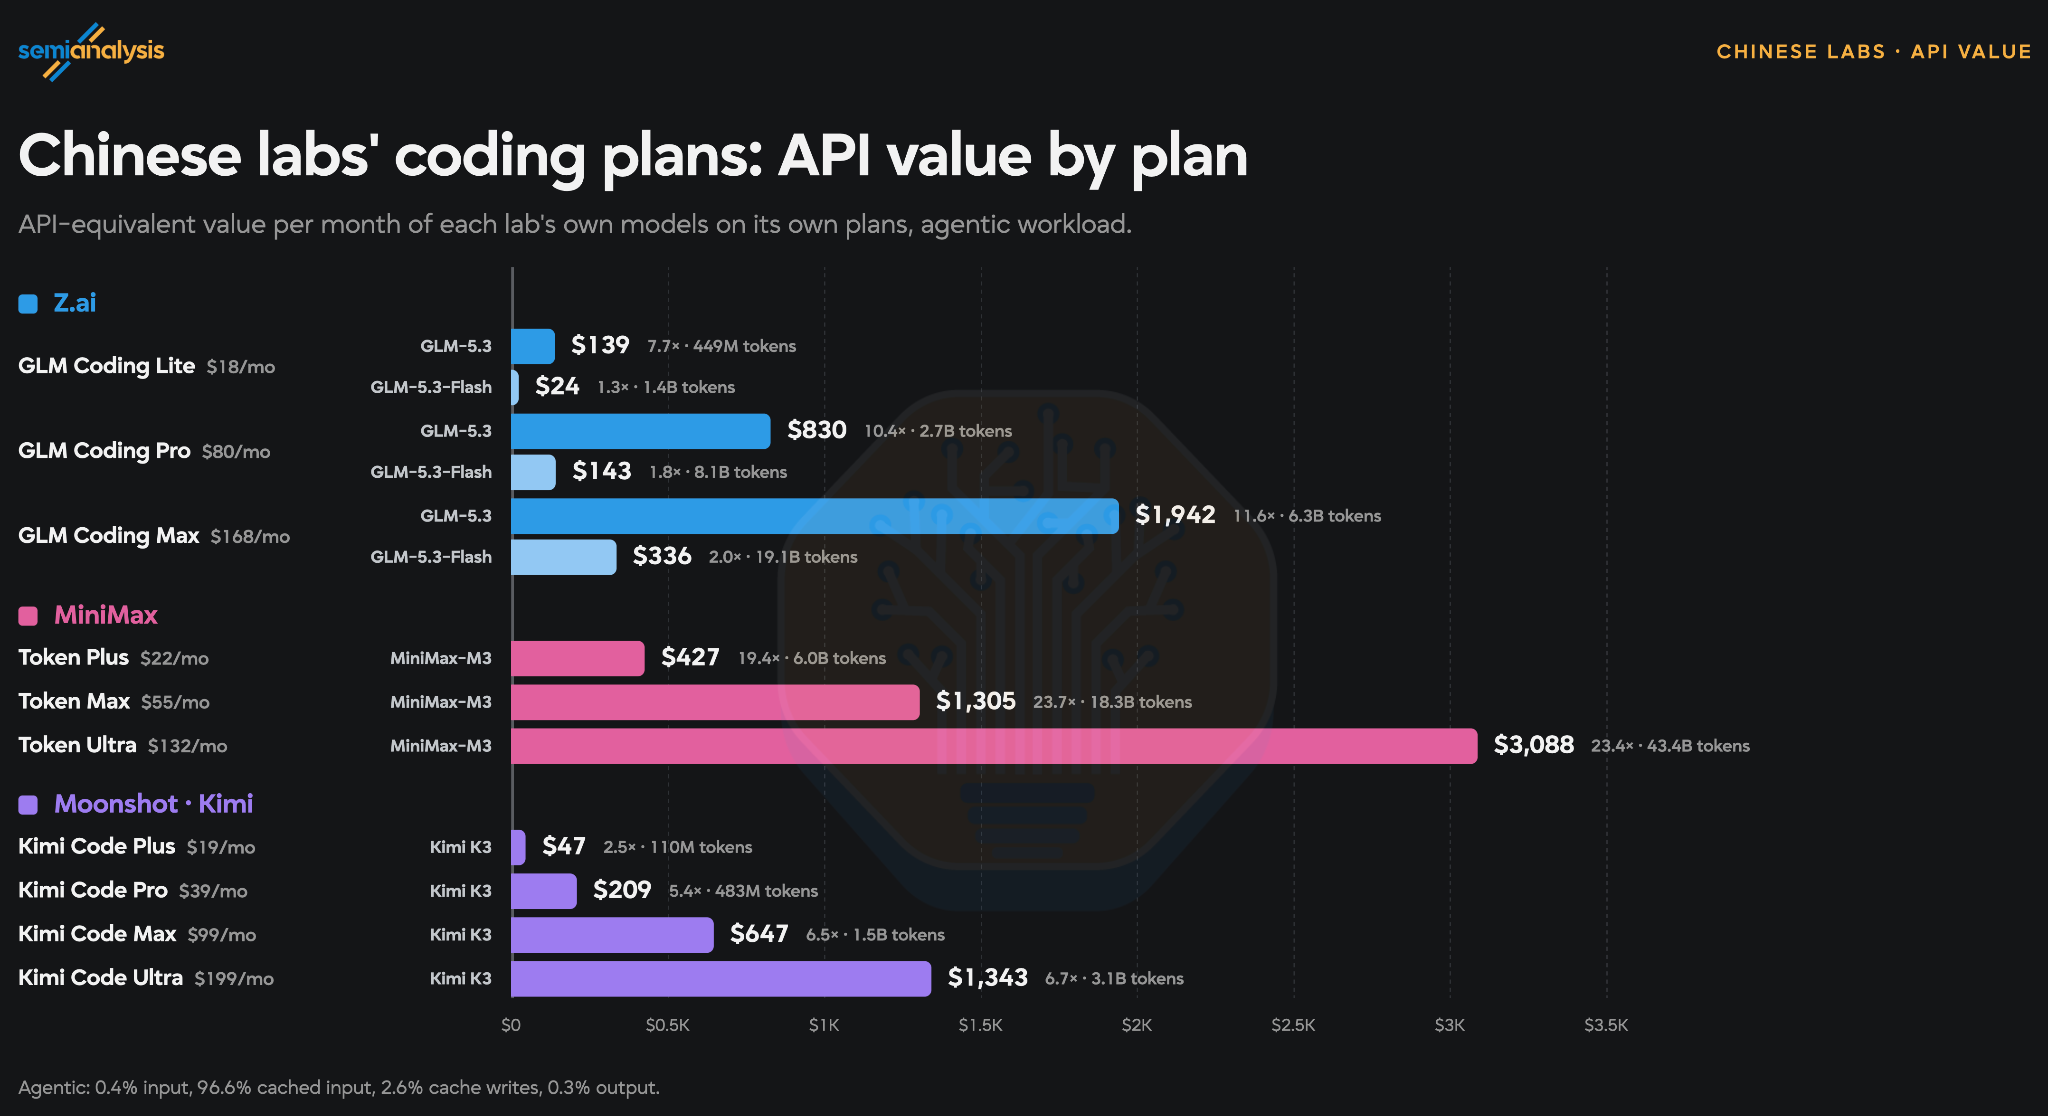
本文解读:同属国产订阅,折算结果也有较大差距。高档位的额度增幅、模型 API 单价、缓存计价都会影响排序。跨厂商比较需要统一订阅费和工作负载,再增加模型实际完成任务的表现这一维度。按订阅费归一化的原图。
这些额度如何影响厂商成本
原文的毛利模型采用 API 毛利率 92% 的假设,进而把 API 等值金额的 8% 当作对应推理成本。用这个模型推演,$200 的 Opus 套餐满额使用时,成本约为 $11,726 × 8% ≈ $938;若平均只使用 20% 额度,成本约为 $188。
这是基于成本率与利用率假设的模型估算。提高可用额度、调整高级模型限额,以及用户到底用了多少,都能改变估算结果。Claude 订阅毛利模型、OpenAI 订阅毛利模型。
我的阅读笔记
在原文测量口径内,Opus 5.5 对比 GPT-6.1 Sol,Claude 的 API 等值额度与总 token 数量都更高。「五倍」对应前一项,后者约为 2.7–2.9 倍。高端模型、普通聊天及不同套餐,需要各自计算。
对实际开发任务,我会把比较分成三步:先记录订阅能提供的额度,再记录缓存、输入与输出的使用结构,最后记录任务完成率、耗时和返工次数。前两步解释资源消耗,第三步帮助评价产出。
这篇文章最值得借鉴的是把用量计转换为可检验数据的方法。这里保留原文日期、模型版本、工作负载和图表出处,方便以后在额度变化时回查比较基准。